 Paso Fusion聯絡方案工程師
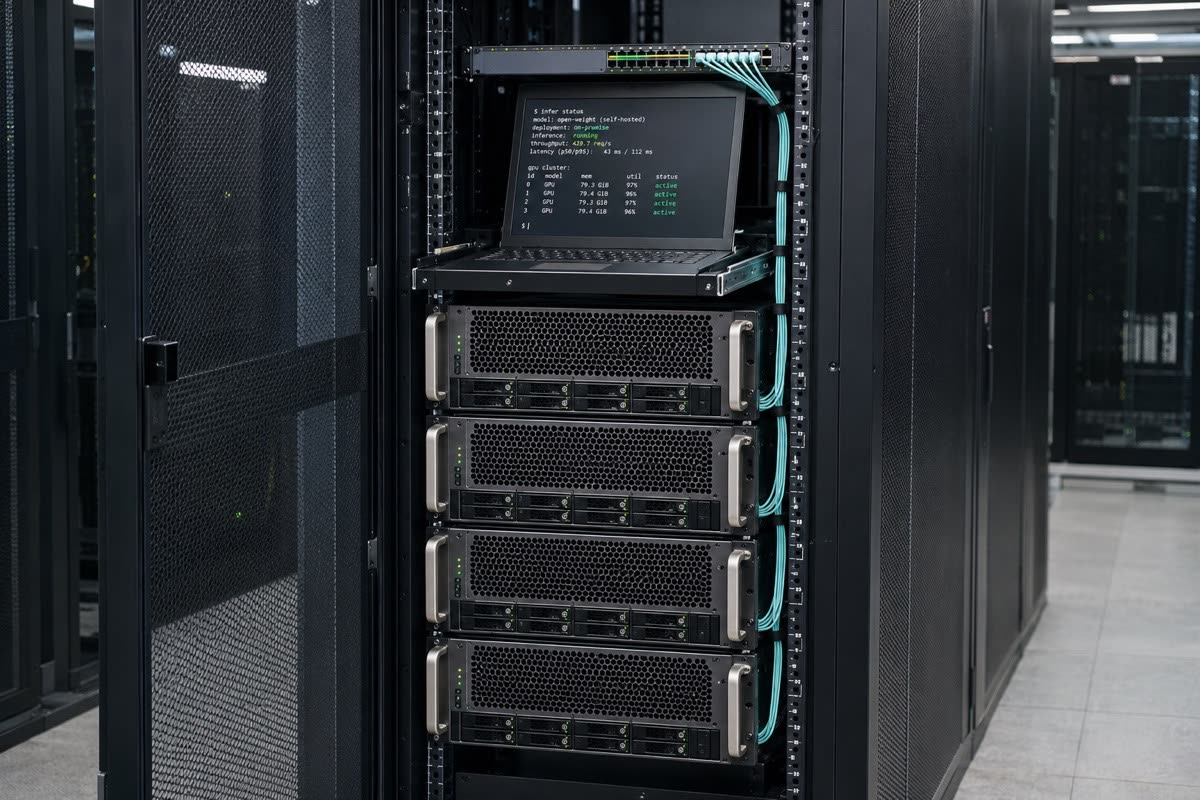
語言模型與影片生成模型的部署需求
開放權重模型自託管需同時兼顧模型架構特徵與業務請求分佈;大語言模型重點受上下文長度、鍵值快取佔用、批處理並發數及首字與生成延遲約束
影片生成模型(例如 MiniMax H3 這一影片模型示例)則對輸出解析度、幀率、生成時長及單次推理計算耗時更為敏感,在顯存峰值與單任務獨佔時間上與文本推理存在明顯差異
開放權重並不等同於通用開源許可,項目啟動時需結合模型發佈方條款核對商用範圍、衍生要求與部署限制
顯存、精度與並行配置
模型權重載入、激活值與快取共同決定單實例顯存邊界;是否採用 FP16、BF16、FP8 或更低比特量化,需結合具體模型結構、推理引擎支援度及任務品質損失綜合評估
單卡顯存不足或單機吞吐受限時,需按模型特徵與底層硬件互聯能力評估張量並行、流水線並行、序列並行或顯存卸載策略,避免脫離實際模型與引擎條件套用單一配置
推理引擎、載入與運行驗證
不同推理框架在算子優化、連續批處理、前綴快取及多模態管線支援上各有側重,工程團隊會依據目標模型版本選擇適配的運行環境
在約定測試範圍與可得試用資源內,開展映像檔構建、權重載入耗時的實測,並在代表性輸入長度與並發壓力下驗證吞吐表現、長尾延遲與運行穩定性
多節點與多地域部署安排
當模型規模跨越單機邊界或業務需覆蓋東南亞及周邊多區域用戶時,需統籌規劃機內高速互聯、跨節點網絡頻寬以及模型權重分發路徑
多地域部署會結合上游雲平台在新加坡、東南亞其他節點及澳洲等地的資源可得性,安排主備副本、流量入口與跨區數據同步方案
交付範圍與運行責任
項目交付包含硬件與並行配置清單、推理容器與參數配置說明、驗證報告以及上線切換建議;底層 GPU 實例與機房設施由上游雲服務商提供,Paso Fusion 負責方案設計、資源協調與約定範圍內的工程技術支援
部署輸入對照
範圍、證據與責任按專案確認
| 輸入項 | 需準備資訊 | 評估事項 |
|---|---|---|
| 模型權重 | 版本、格式與許可 | 引擎相容性與使用範圍 |
| 輸出規格 | 上下文分布或影片生成設定 | 顯存峰值與執行時間 |
| 流量 | 並行、批次處理與佇列優先級 | 副本規劃與排程約束 |
| 顯存預算 | 精度、快取與啟用值要求 | 平行與卸載選項 |
| 互聯 | 機內與節點間通訊需求 | 實測通訊基線 |
| 儲存與交付 | 權重分發與成果存放位置 | 傳輸費用與存取責任 |