 Paso Fusion联系方案工程师
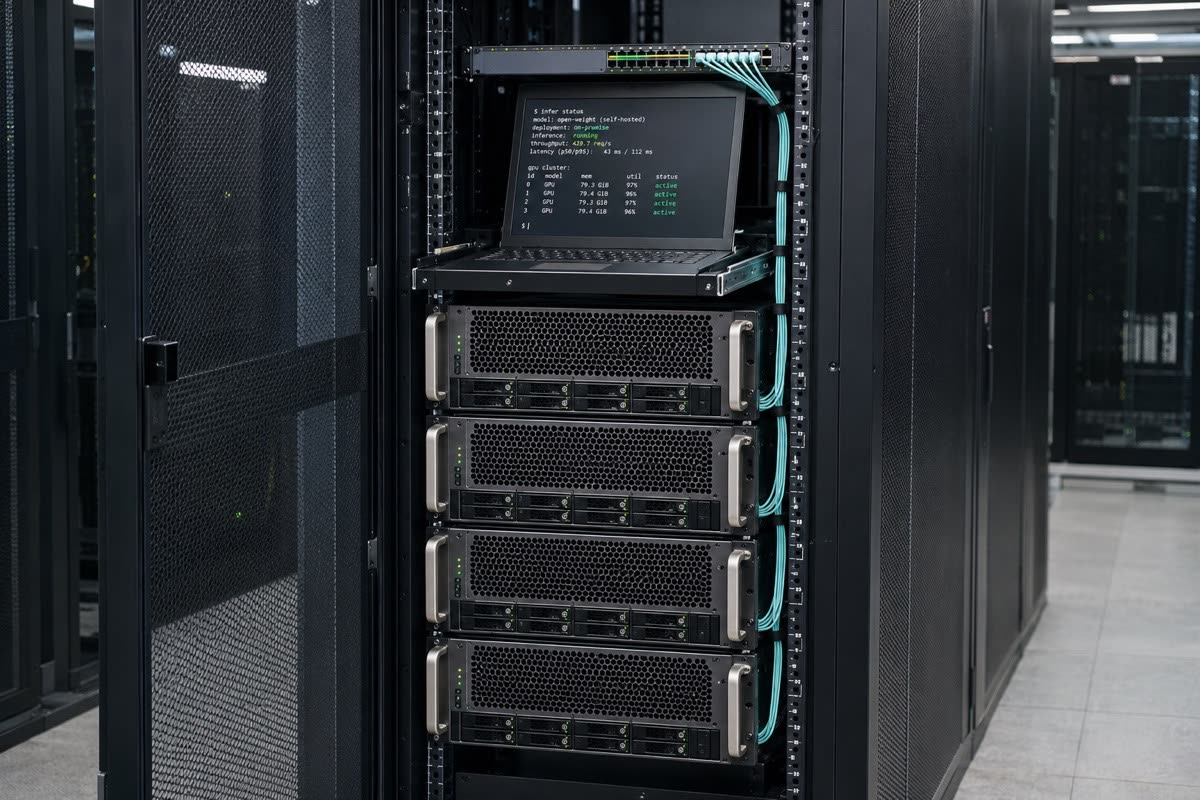
语言模型与视频生成模型的部署需求
开放权重模型自托管需同时兼顾模型架构特征与业务请求分布;大语言模型重点受上下文长度、键值缓存占用、批处理并发数及首字与生成延迟约束
视频生成模型(例如 MiniMax H3 这一视频模型示例)则对输出分辨率、帧率、生成时长及单次推理计算耗时更为敏感,在显存峰值与单任务独占时间上与文本推理存在明显差异
开放权重并不等同于通用开源许可,项目启动时需结合模型发布方条款核对商用范围、衍生要求与部署限制
显存、精度与并行配置
模型权重加载、激活值与缓存共同决定单实例显存边界;是否采用 FP16、BF16、FP8 或更低比特量化,需结合具体模型结构、推理引擎支持度及任务质量损失综合评估
单卡显存不足或单机吞吐受限时,需按模型特征与底层硬件互联能力评估张量并行、流水线并行、序列并行或显存卸载策略,避免脱离实际模型与引擎条件套用单一配置
推理引擎、加载与运行验证
不同推理框架在算子优化、连续批处理、前缀缓存及多模态管线支持上各有侧重,工程团队会依据目标模型版本选择适配的运行环境
在约定测试范围与可得试用资源内,开展镜像构建、权重加载耗时的实测,并在代表性输入长度与并发压力下验证吞吐表现、长尾延迟与运行稳定性
多节点与多地域部署安排
当模型规模跨越单机边界或业务需覆盖东南亚及周边多区域用户时,需统筹规划机内高速互联、跨节点网络带宽以及模型权重分发路径
多地域部署会结合上游云平台在新加坡、东南亚其他节点及澳大利亚等地的资源可得性,安排主备副本、流量入口与跨区数据同步方案
交付范围与运行责任
项目交付包含硬件与并行配置清单、推理容器与参数配置说明、验证报告以及上线切换建议;底层 GPU 实例与机房设施由上游云服务商提供,Paso Fusion 负责方案设计、资源协调与约定范围内的工程技术支持
部署输入对照
范围、证据与责任按项目确认
| 输入项 | 需准备信息 | 评估事项 |
|---|---|---|
| 模型权重 | 版本、格式与许可 | 引擎兼容性与使用范围 |
| 输出规格 | 上下文分布或视频生成设置 | 显存峰值与执行时间 |
| 流量 | 并发、批处理与队列优先级 | 副本规划与调度约束 |
| 显存预算 | 精度、缓存与激活值要求 | 并行与卸载选项 |
| 互联 | 机内与节点间通信需求 | 实测通信基线 |
| 存储与交付 | 权重分发与成果存放位置 | 传输费用与访问责任 |